AIBase
Whisper:语音识别与转录质量检查
语音模型将声音转为文字,姓名、数字和静音区域是重点审核对象。
阅读重点
- 测试口音与噪声样本
- 复核姓名和数字
- 保留原音频与版本信息
识别任务与模型输出
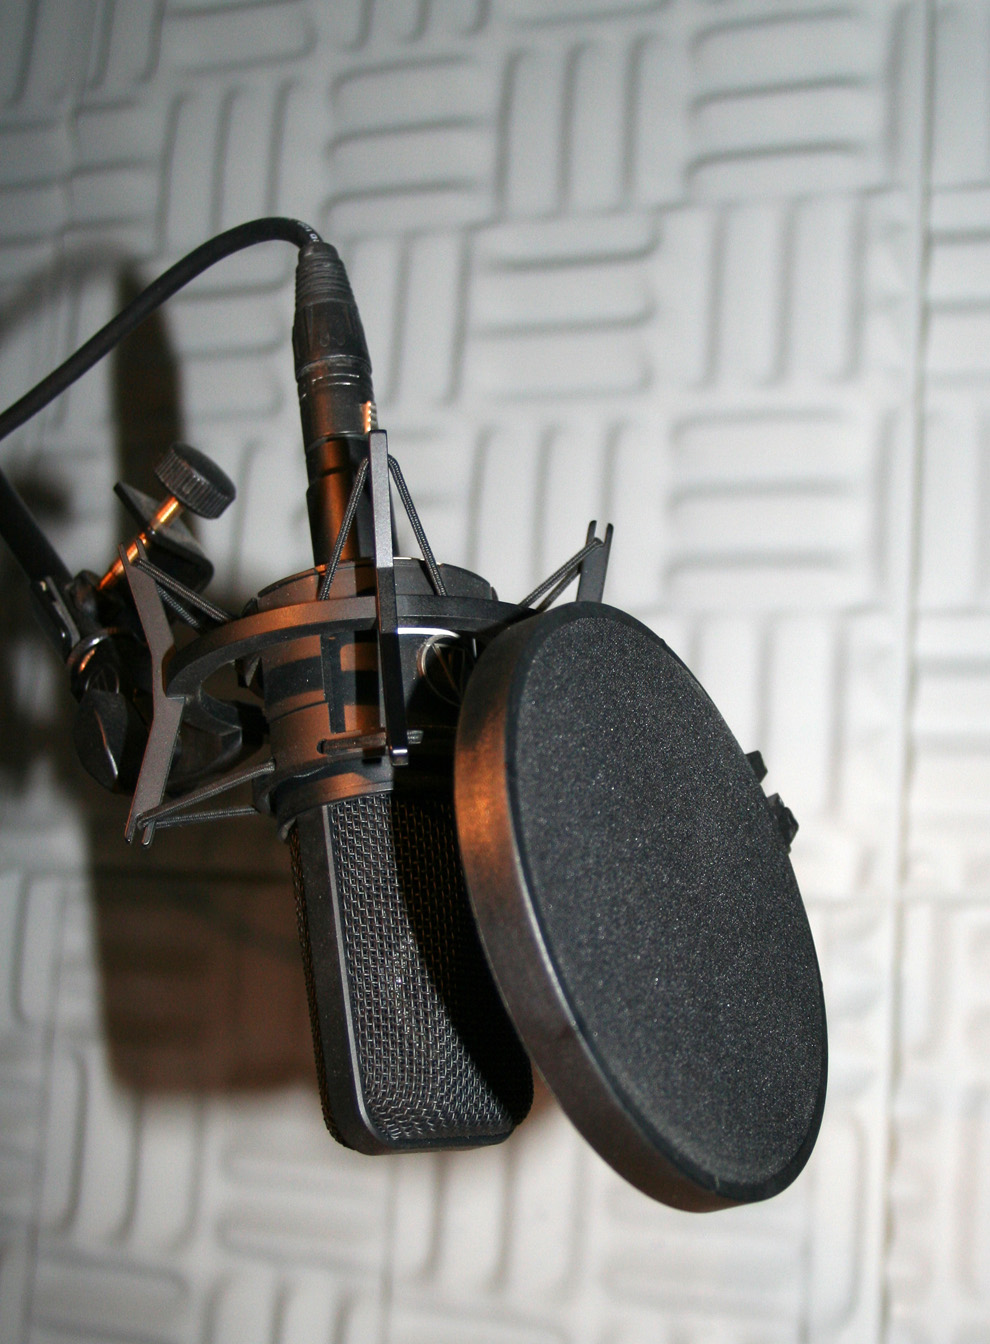
Whisper 的公开代码与模型用于语音识别和相关任务。转录结果是对录音的模型解释,不能默认每个字都来自真实发言。
模型版本、语言、录音条件与运行参数都会影响表现。记录输入和版本有助于后续复核。
准备真实录音样本
测试材料应包含常见语言、口音和背景声,同时保留一些难例,例如多人接话、远距离录音与技术词。清晰单人发言通常更容易审核,但它不能代表全部会议。
不同测试材料应使用一致的评价方法。
识别常见错误
姓名、金额、时间和单位的错误往往比标点错误更有影响。没有清楚发言的片段也需要检查,不能因为输出句子完整就认定录音包含该内容。
对于需要引用的片段,应保存原始音频与对应时间位置。
接入实际业务
模型转录可以进入字幕、检索或记录流程,但后续摘要和行动项又涉及其他处理。不要把转录准确率直接当作整个工作流的完成质量。
上线前确认文件保存、访问权限、错误反馈和人工校对步骤。
相关工具与模型

读者常问
转录文字能直接作为正式记录吗?
重要记录应对照录音校验,特别是姓名、金额、期限与决定。
Whisper 是完整会议软件吗?
不是。语音模型与会议应用负责的工作不同。